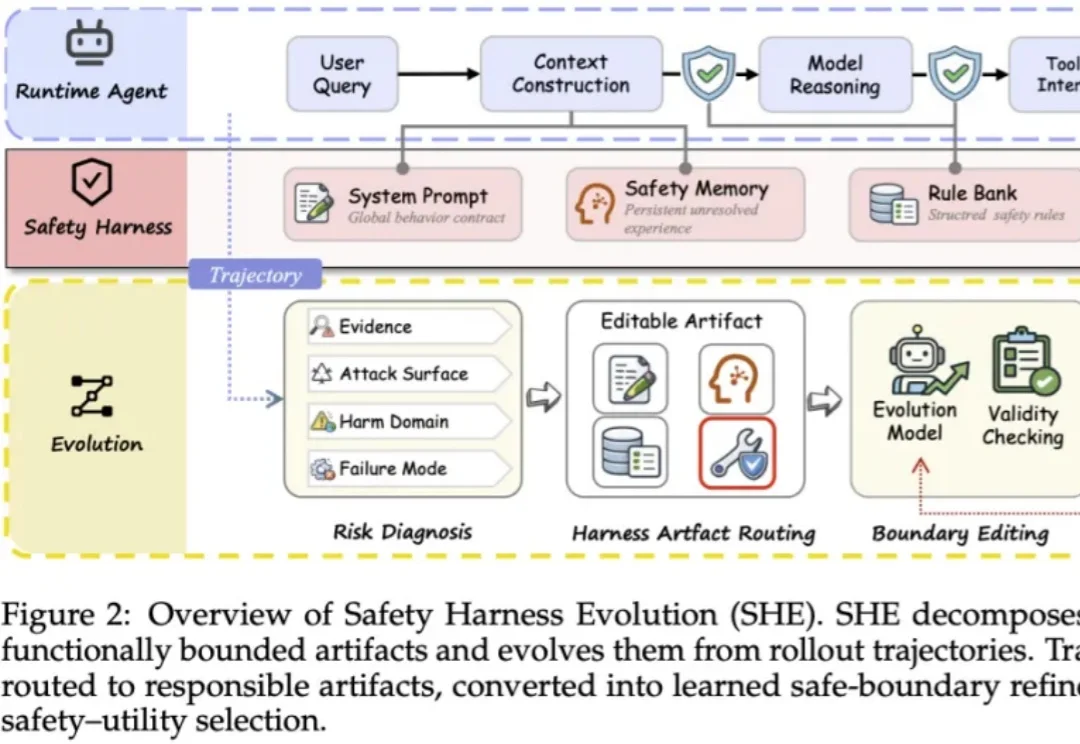
AI Agent安全不能只靠Prompt了:上海AI Lab探索Agent安全进化新范式
AI Agent安全不能只靠Prompt了:上海AI Lab探索Agent安全进化新范式大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
来自主题: AI技术研报
7390 点击 2026-09-17 14:55

 搜索
大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
当 AI Agent 开始连续数小时替人工作,真正有价值的就不只是最终成果,还有藏在会话(Session)里的整个过程:它做过什么、哪里失败、为何改变方向。
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
AI Simulation赛道持续升温,Simile估值达20亿美元、由00后创办的Aaru估值近10亿美元、MatrAIx构建83亿虚拟人格,企业通过让AI Agent模拟人类行为来测试产品和预测尚未发生的未来,但这门生意仍面临验证标准、预测精度和规模化等核心难题。
一个 Agent 第一次没把任务做对。
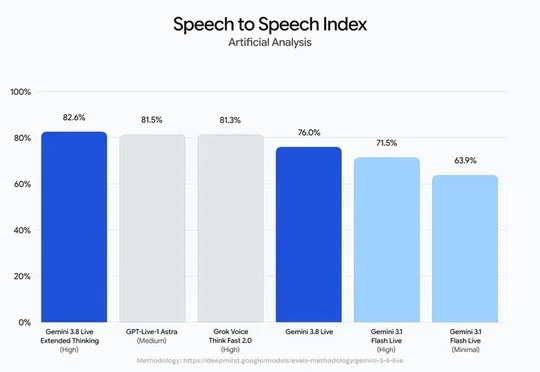
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
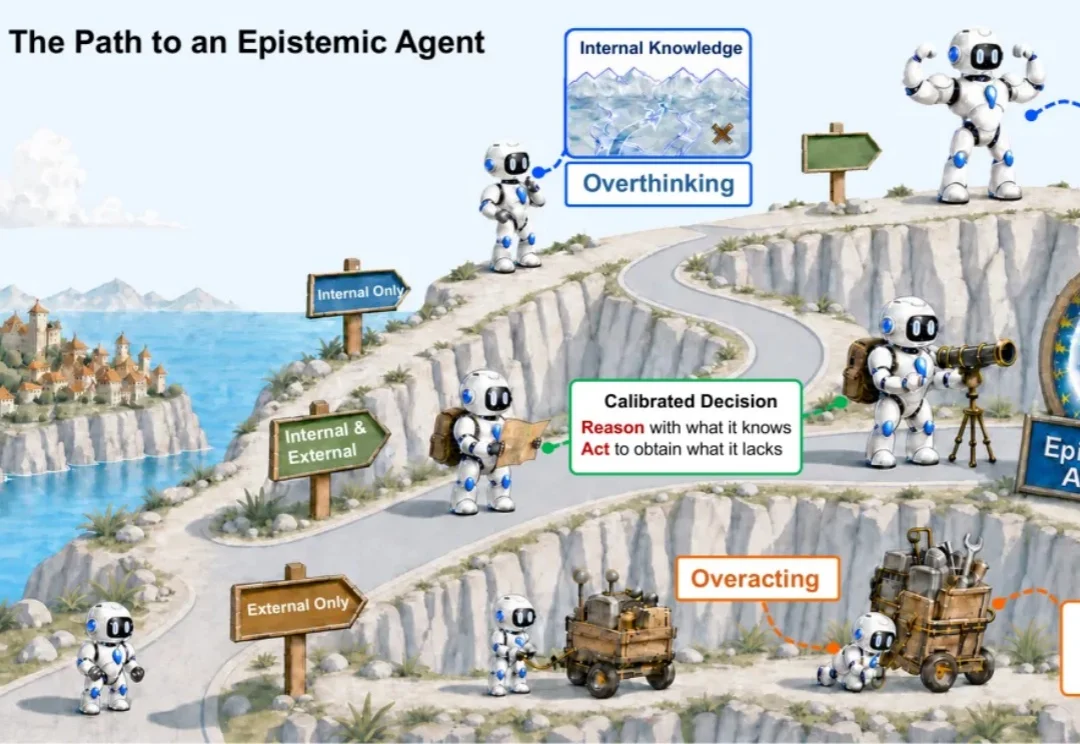
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
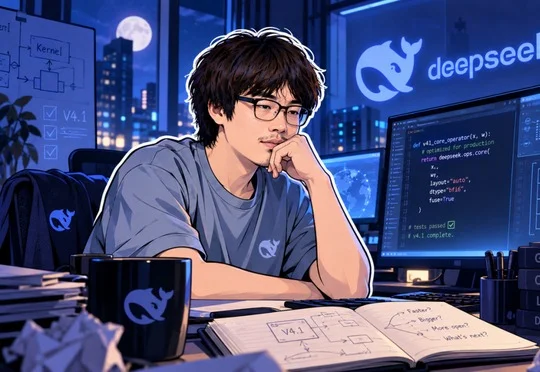
DeepSeek资深MLSys工程师刘胜与深夜发文,坦承刚完成V4.1核心算子交付后,意识到AI已能自主编写和优化GPU算子,正迫使他从手写底层算子转向驾驭AI Agent的"机甲驾驶员",并警示工程底层能力空心化可能带来系统性风险。
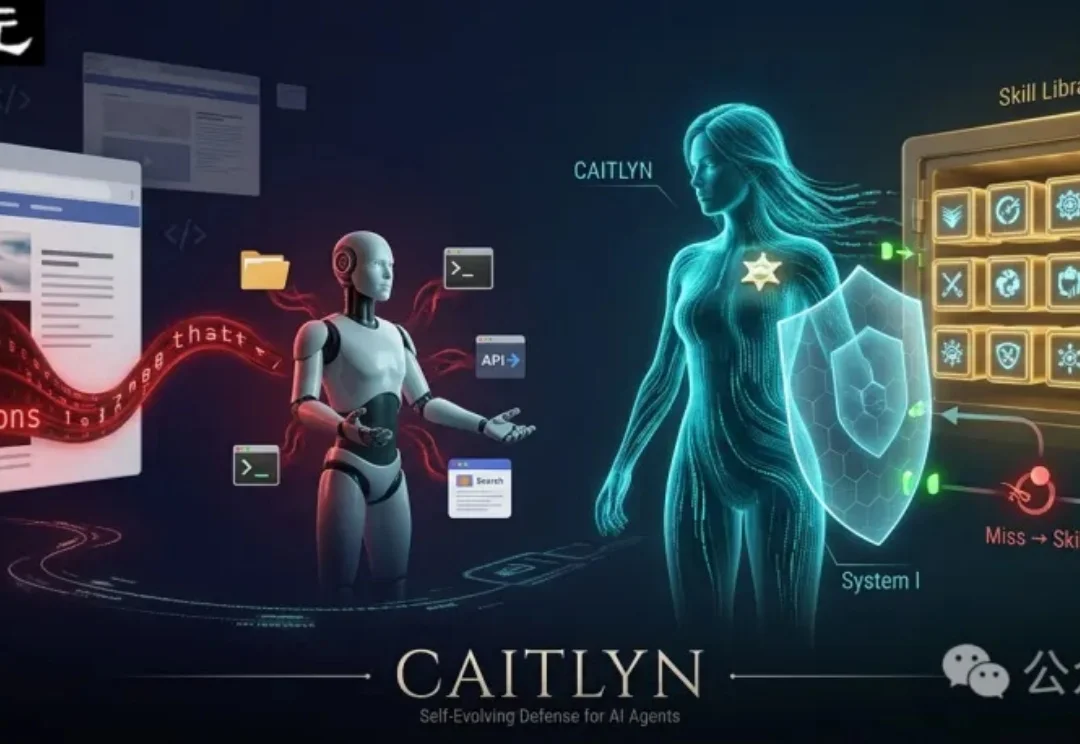
今天的AI Agent,已经不只是聊天窗口里「会说话」的模型。它们正在接入浏览器、文件系统、终端、API、MCP服务和各种自动化工作流,开始真正替用户执行任务。
同一套模型,换一个coding agent运行时,测试得分和实际消耗往往大相径庭。